Vom Gold-Foto zur strukturierten Eingangskontrolle
AbgeschlossenVision-Modelle, PDF-Extraktion und Review-Interface: ein durchgehender Intake-Flow für physische Assets, in vier Wochen.
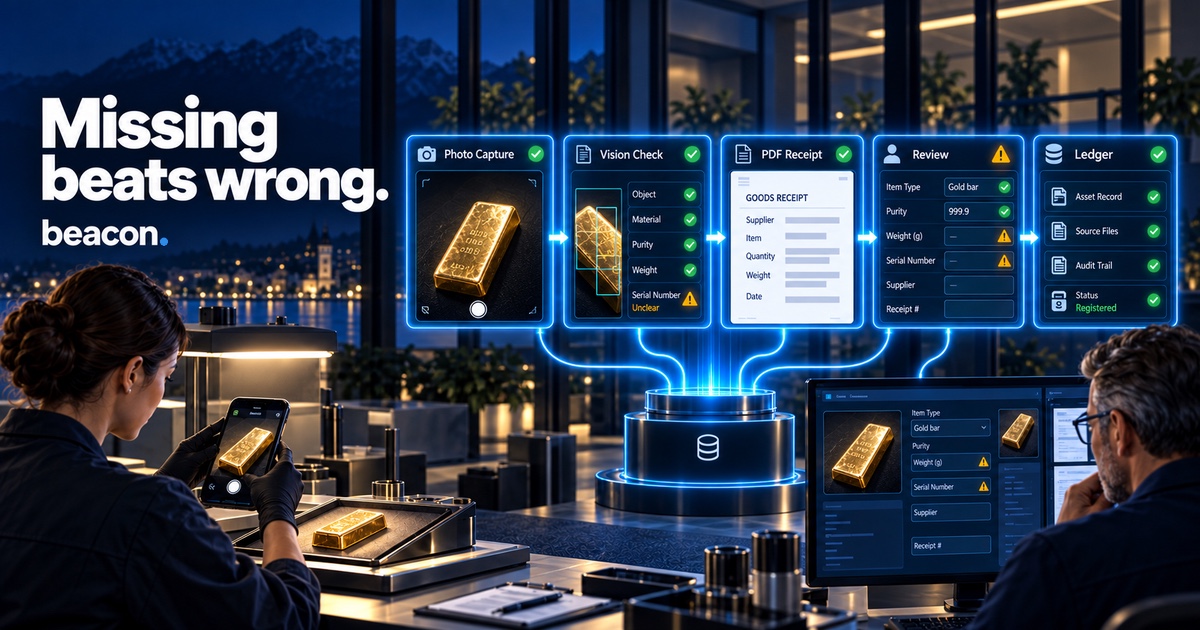
Was gebaut wurde
Ein durchgehender Intake-Flow für physische Assets. Eine mobile App fotografiert das Objekt, ein Python-Backend erkennt es per multimodalem Vision-Modell, ein web-basiertes Review-Interface ermöglicht die manuelle Verifikation und schreibt den verifizierten Wareneingang automatisch ins operative Ledger. Parallel dazu: ein LLM-gestützter Extraktions-Service für eingehende PDF-Wareneingänge, der gegen denselben Ledger abgleicht.
Vier Komponenten, ein Flow. Zwei grundlegend verschiedene Erkennungsprobleme (Bild und Dokument) unter derselben Rahmenbedingung.
Die Rahmenbedingung
Fehlertoleranz nahe null. Ein falsches Erkennungsergebnis ist gefährlicher als gar keines. Das System musste lernen, sicher abzulehnen, nicht um jeden Preis zu erkennen.
Diese eine Anforderung hat jede Architekturentscheidung geprägt: die Wahl der LLM-Strategie, die Struktur des Review-Interface, das Design der Fallback-Logik, und das Prompt Engineering für den PDF-Extraktor. Das zentrale Designprinzip, das daraus entstand: “missing beats wrong”: ein leeres Feld ist besser als ein erfundener Wert.
Der Tech Stack
Mobile App in React Native mit Expo für Kamera-Integration und Upload-Flow. Das Erkennungs-Backend in Python mit FastAPI, gebaut auf einer pluggable Strategy-Architektur: jede LLM-Strategie implementiert dasselbe Interface, ist austauschbar und einzeln benchmarkbar. Das Review-Interface als Web-App in 2–3 Tagen from scratch: Supabase als Datenbank und Auth-Backend, S3 für Bild-Storage, React-Frontend. Schnell, weil der Scope klar war.
Der Weg zum richtigen Modell
Klassisches OCR scheitert sofort. Eingravierter Text auf reflektierenden Metalloberflächen hat keinen Farbkontrast. Lokale Vision-Modelle waren vielversprechend, aber instabil: hohe Timeout-Raten, Halluzinationen bei Seriennummern, untragbare Inferenz-Zeiten auf CPU-Hardware.
Kein einzelnes Modell war in allen Feldern gleichzeitig gut. Die finale Strategie kombiniert zwei Modelle mit feldspezifischer Merge-Logik und ruft das zweite nur dann auf, wenn das erste kritische Felder nicht auflösen konnte. Am Ende übertraf die Cloud-Vision-API alle lokalen Strategien in Accuracy und Latenz. Dieser Befund war das Ergebnis eines strukturierten Benchmarks, nicht einer Annahme zu Beginn.
Das härtere Problem
Nach der Demo-Abnahme war die eigentlich knifflige Arbeit noch nicht erledigt. PDF-Wareneingänge verschiedener Lieferanten sind strukturell heterogen: unterschiedliche Layouts, Datumsformate, Einheiten, Sprachen. Das Modell muss nicht nur extrahieren: es muss entscheiden, was es nicht wissen kann, und das explizit signalisieren.
Die Lösung: ein Extraction-Prompt mit Runtime-Injection von Whitelist-Rahmenbedingungen, strikt getrennt nach System-Prompt und User-Prompt. Das Modell bekommt zur Laufzeit genau die Rahmenbedingungen, die für den jeweiligen Issuer gelten. reconciliation_ready wird nur auf true gesetzt, wenn alle Pflichtfelder vollständig und plausibel sind. Das Modell lehnt implizit ab, indem es Felder leer lässt.
Was daraus bleibt
Ob Vision-Modell oder PDF-Extraktor: die eigentliche Arbeit liegt nicht darin, das Modell auf Vollständigkeit zu optimieren, sondern darin zu definieren, wann es sicher nicht erkennt. Wer das zu spät definiert, baut das System zweimal. Und die finale LLM-Strategie war zu Beginn nicht vorhersehbar. Erst ein strukturierter Benchmark hat gezeigt, welche Kombination unter den gegebenen Rahmenbedingungen funktioniert.